

Inhoudsopgave
- Werkt GEO echt of is het weer een hype?
- Waarom wilde Doublesmart experimenteren met SEO voor AI?
- Wat we wilden onderzoeken
- Deel 1: De 4 fases van het experiment
- Deel 2: Wat de serverlogdata ons leerde
- Hoe analyseer je je zichtbaarheid in AI-zoekresultaten?
- De belangrijkste lessen op een rij
- Wat betekent dit voor jouw bedrijf?

Deel dit artikel
Deze pagina direct samenvatten
Iedereen heeft een mening over GEO. Wij hebben een meting. Twaalf maanden volgden we 20 bedrijven in uiteenlopende branches. Met een eigen serverlog-meetlaag legden we 846.677 AI-crawlerhits vast op 86.524 pagina’s. Dit GEO-experiment laat zien wat die data zegt over ranken in AI, welke aannames sneuvelden en hoe je je eigen zichtbaarheid in AI-zoekresultaten analyseert.
Hoe analyseer je je zichtbaarheid in AI-zoekresultaten? Combineer drie bronnen. Serverlogs laten zien welke AI-crawlers je pagina’s ophalen. GA4 laat zien wie daarna doorklikt vanuit ChatGPT of Perplexity. Promptchecks laten zien of je terugkomt in de antwoorden zelf. Alleen serverlogdata legt het ophalen vast, ook als er nooit een klik volgt.
Werkt GEO echt of is het weer een hype?
Eerlijk antwoord: allebei een beetje.
Om GEO heen zit veel lawaai. Bureaus verkopen checklists, LinkedIn staat vol stellige uitspraken en vrijwel niemand laat data zien. Dat deel is hype.
Onder dat lawaai gebeurt iets meetbaars. AI-crawlers halen dagelijks pagina’s op en die verzoeken staan in je serverlogs. In onze analyse kwam een crawl in meer dan 98% van de onderzochte gevallen overeen met een vertoning in ChatGPT-antwoorden. Dat is geen aanname. Dat is een geregistreerd verzoek met een tijdstempel.
Wat we níét kunnen doen, zeggen we er meteen bij. We kunnen niet in een taalmodel kijken. We kunnen geen positie garanderen, geen zoekvolume noemen en geen vaste formule voor ranken in AI verkopen. We kunnen wel laten zien welke pagina’s worden opgehaald, door welke crawler en hoe vaak. Dat is het verschil tussen een mening over GEO en een meting.
Waarom wilde Doublesmart experimenteren met SEO voor AI?
De manier waarop mensen online informatie zoeken, verandert sneller dan in de afgelopen tien jaar SEO in totaal is veranderd. Jarenlang was de gewoonte simpel. Je typt een zoekterm in Google, je krijgt tien blauwe links, en je klikt op de meest relevante. Die gewoonte staat onder druk.
Steeds meer mensen stellen hun vraag niet meer aan een zoekmachine, maar rechtstreeks aan een AI-systeem. Denk aan ChatGPT, Gemini, Claude, Perplexity en Copilot. En aan de AI-functies die inmiddels standaard in Google Search zitten, zoals AI Overviews en AI Mode.
Het verschil is fundamenteel. Een traditionele zoekmachine toont een lijst met opties en laat je zelf kiezen. Een AI-systeem doet dat keuzewerk voor je. Het haalt informatie op uit meerdere bronnen, weegt die tegen elkaar af en formuleert één samenhangend antwoord. Vaak zonder dat er nog een lijst met links bij hoort.
Vraag je ChatGPT welke leverancier het beste past bij jouw situatie, dan krijg je een vergelijking en een concrete aanbeveling. Geen tien zoekresultaten om zelf doorheen te spitten.
Voor bedrijven ontstaat daardoor een indringende vraag. Als de gebruiker niet meer zelf uit een lijst kiest, hoe zorg je er dan voor dat jouw bedrijf onderdeel wordt van het antwoord dat wél getoond wordt?
Dat is de kernvraag achter Generative Engine Optimization, oftewel GEO. Het draait om het optimaliseren van content, techniek en autoriteit, zodat AI-systemen jouw informatie kunnen vinden, verwerken en gebruiken in hun antwoorden.
Toen wij bij Doublesmart begin 2025 met dit vraagstuk aan de slag gingen, was GEO nog een nieuw en onvolwassen vakgebied. Er was volop interesse. Iedereen voelde dat hier iets structureels aan het veranderen was. Maar bewezen methodes, betrouwbare meetmodellen en harde benchmarks waren er nauwelijks. Vrijwel alles wat er destijds over GEO werd geschreven, bestond uit aannames, losse observaties of marketingclaims zonder onderbouwing.
Precies daarom behandelden we GEO als een experiment. We beloofden vooraf geen exacte resultaten. Wél dat we systematisch zouden testen, zouden leren, en die kennis direct zouden delen met de bedrijven die meededen. En we gingen er ook de markt mee op en waren het eerste bureau met een GEO-specialist in dienst.
Waarom dit geen n=1-verhaal over onze eigen website is
De makkelijkste manier om een GEO-succesverhaal te schrijven, is je eigen site optimaliseren en de uitkomst een onderzoek noemen. Daar hebben we bewust niet voor gekozen.
De 846.677 crawlerhits komen van 20 deelnemende bedrijfswebsites, verdeeld over twee groepen en meerdere branches. Webshops en dienstverleners, kleine domeinen en domeinen met tienduizenden URL’s. Daardoor zie je welke patronen overal terugkomen en welke alleen in één situatie opgaan. GEO gedraagt zich namelijk per branche en per uitgangssituatie anders.
Dat is ook de grens van dit onderzoek. Twintig bedrijven is genoeg voor patronen. Het is te weinig voor statistische zekerheid per branche. Waar we iets zien maar niet kunnen hardmaken, staat dat er letterlijk bij.
Wat we wilden onderzoeken
Om richting te geven aan een onderwerp waarvoor nog geen gebaande paden bestonden, formuleerden we vier centrale onderzoeksvragen. Niet toevallig lijken ze sterk op de vragen die vrijwel elke marketeer zich op dit moment stelt:
| # | Onderzoeksvraag |
| 1 | Welke technische randvoorwaarden zijn belangrijk voor zichtbaarheid in AI-antwoorden? |
| 2 | Welke contentkenmerken dragen mogelijk bij aan die zichtbaarheid? |
| 3 | Hoe maak je GEO beter meetbaar dan met bestaande tools (GA4, Search Console, promptchecks)? |
| 4 | Hoe vertaal je die inzichten naar een praktische, herhaalbare aanpak? |
Deze vier vragen vormden het kompas voor het hele traject. Ook wanneer een deelexperiment geen eenduidig antwoord opleverde, wisten we waarom we het deden. Dat mag een open deur klinken. Maar in een vakgebied zonder benchmarks verzand je zonder heldere onderzoeksvragen al snel in losse experimentjes zonder rode draad.
Deel 1: De 4 fases van het experiment
Een experiment van 12 maanden bij 20 bedrijven vraagt om structuur. Daarom deelden we het traject op in vier fases, elk met een eigen vraag en een eigen soort opbrengst. Gaandeweg verschoof de aanpak van puur experimenteren naar een steeds datagedrevener en strategischer proces.
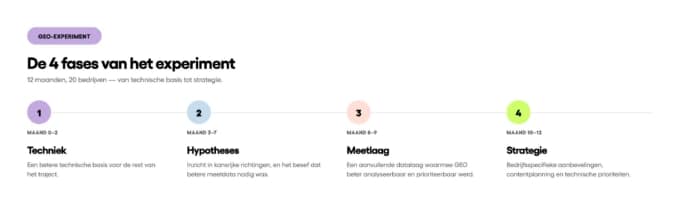
Fase 1 (maand 0-2): technische GEO-basis
In de eerste twee maanden lag de nadruk volledig op technische randvoorwaarden. Dat was een bewuste keuze. Is content technisch moeilijk bereikbaar, wordt hij verkeerd gerenderd of per ongeluk geblokkeerd via robots.txt, dan kun je later niet bepalen of contentaanpassingen iets doen. Je meet dan vooral de technische beperkingen van de website.
Daarom keken we in deze fase naar crawlability, JavaScript-rendering, robots.txt, sitemaps, indexeerbaarheid, llms.txt en IndexNow. Technische blokkades kunnen zichtbaarheid beperken, voor traditionele zoekmachines en voor AI-crawlers. Dat was de reden. Techniek bleek later niet de grootste hefboom voor GEO.
Fase 2 (maand 3-7): hypotheses testen
Met een gezonde technische basis konden we vijf maanden lang concrete hypotheses testen. Die vielen uiteen in vier categorieën:
- contenthypotheses: pagina’s uitbreiden met context, definities en veelgestelde vragen;
- technische hypotheses: structured data, llms.txt en IndexNow;
- hypotheses rond interne linking en templates;
- hypotheses rond autoriteit en externe signalen, zoals reviews en mentions.
Deze fase leverde waardevolle signalen op. Maar ook een duidelijke beperking. Het is knap lastig om de impact van één losse aanpassing vast te stellen als je alleen Google Search Console en GA4 hebt. Die tools laten zien hoe je scoort in Google. Ze vertellen niets over of een AI-systeem jouw pagina heeft opgehaald en gebruikt.
Fase 3 (maand 8-9): een eigen meetlaag ontwikkelen
Die beperking werd het keerpunt van het traject. De centrale vraag verschoof van “welke test doen we deze maand” naar “welke data hebben we nodig om GEO te kunnen beoordelen”.
Het antwoord lag in serverlogs. Dat zijn de logbestanden die elk verzoek op een website vastleggen, inclusief bezoeken van AI-crawlers zoals GPTBot en ClaudeBot. Google Analytics laat zien wie er via een AI-tool doorklikt naar je website. Serverlogs laten zien welke pagina’s überhaupt door AI-crawlers worden opgehaald, nog vóór er een klik is.
Dat onderscheid bleek doorslaggevend. De ontwikkeling van onze eigen AI-logger werd de belangrijkste opbrengst van deze fase. We gaan hier in deel 2 dieper op in.
Fase 4 (maand 10-12): strategie en structurele waarde
In de laatste drie maanden vertaalden we alles naar concrete, bedrijfsspecifieke aanbevelingen. Welke bestaande pagina’s verdienen prioriteit? Welke templates zijn schaalbaar te verbeteren? En welke nieuwe content is de moeite waard om te maken? Zo eindigde het experiment met een structurele aanpak, een concreet vervolgpad en een contentplanning per deelnemend bedrijf.
Deel 2: Wat de serverlogdata ons leerde
Serverlogs klinken technisch, maar het principe is eenvoudig. Vraagt iemand, of iets zoals een crawler, een pagina op je website op, dan registreert de server dat verzoek. Welke URL, wanneer, en door wie of wat.
SEO-specialisten gebruiken die data traditioneel om te controleren of Googlebot alle belangrijke pagina’s bezoekt. Voor GEO zit er informatie in die je nergens anders vandaan haalt. Serverlogs laten namelijk zien welke pagina’s specifiek door AI-crawlers worden opgehaald.
Dat onderscheid is belangrijker dan het klinkt. Google Analytics vertelt je of iemand vanuit ChatGPT naar je website is doorgeklikt. Het vertelt je niets over de momenten waarop een AI-systeem je pagina wél heeft opgehaald en gebruikt om een antwoord te vormen, zonder dat er ooit een klik volgt. Juist dat onzichtbare gebruik van je content maken serverlogs zichtbaar.
Om dit signaal te kunnen gebruiken, moesten we eerst weten hoe sterk crawleractiviteit samenhangt met zichtbaarheid in AI-antwoorden. Het antwoord was eenduidig. In onze analyse kwam een crawl in meer dan 98% van de onderzochte gevallen overeen met een daadwerkelijke vertoning in ChatGPT-antwoorden.
Haalt een AI-crawler je pagina op, dan is de kans zeer groot dat die content in een antwoord terechtkomt. Daarmee werd serverlogdata voor ons een bruikbaar signaal om AI-zichtbaarheid te analyseren, in plaats van een theoretische aanname.
Wat er feitelijk gebeurt als een AI-crawler je site ophaalt
Stap voor stap, zonder mystiek:
- Iemand stelt een vraag in ChatGPT, Perplexity of Claude.
- Het systeem bepaalt dat het actuele webinformatie nodig heeft en vraagt een URL op.
- Jouw server ontvangt dat verzoek en schrijft één regel in het logbestand: tijdstip, URL, user-agent, statuscode.
- De opgehaalde tekst gaat mee als bronmateriaal voor het antwoord.
- Soms staat er een bronvermelding bij en klikt iemand door. Vaak ook niet.
Stap 3 is het enige moment waarop jij iets kunt vastleggen. Daarna verdwijnt het proces uit je zicht. Daarom is die logregel zo waardevol: het is het harde bewijs dat je content is opgehaald, los van wat er daarna mee gebeurt.
De dataset in cijfers
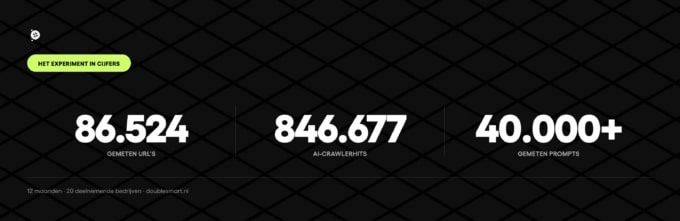
Om dit signaal op schaal te kunnen analyseren, bouwden we een eigen AI-logger die crawleractiviteit continu vastlegt en combineert met bestaande SEO-data. Over de looptijd van het experiment leverde dat de volgende cijfers op:
| Metric | Waarde |
| Aantal gemeten URL’s | 86.524 |
| Aantal AI-crawlerhits | 846.677 |
| Aantal gemeten prompts | 40.000+ |
Welke AI-crawlers kwamen naar voren?
Niet elke crawler doet hetzelfde. Sommige zijn direct gekoppeld aan een concrete gebruikersvraag, andere aan bredere dataverzameling of modeltraining. Zonder dat onderscheid lees je de cijfers verkeerd.
| Crawler | Gecrawlde URL’s | Totaal aantal crawls |
| ChatGPT-user | 26.881 | 382.096 |
| ClaudeBot | 41.575 | 185.893 |
| GPTBot | 50.314 | 169.592 |
| OAI-SearchBot | 19.558 | 71.018 |
| PerplexityBot | 4.473 | 33.429 |
| Claude-User | 605 | 1.653 |
| Perplexity-User | 377 | 696 |
ChatGPT-User is een user-initiated fetcher. Die wordt actief wanneer iemand in ChatGPT een vraag stelt waarbij een webpagina wordt bezocht. OpenAI geeft zelf aan dat ChatGPT-User niet bedoeld is voor automatisch webcrawlen of search-indexering.
OAI-SearchBot is wél gericht op search. Die crawler zorgt ervoor dat websites getoond kunnen worden in ChatGPT Search-resultaten. GPTBot heeft weer een andere functie. OpenAI gebruikt hem om content te verzamelen waarmee modellen getraind of verbeterd worden.
Bij Anthropic zien we een vergelijkbaar onderscheid. Claude-User wordt gebruikt wanneer iemand in Claude een vraag stelt waarbij een website wordt geraadpleegd. Dat is user-initiated verkeer. ClaudeBot verzamelt publiek webmateriaal dat gebruikt kan worden voor modeltraining.
Bij Perplexity werkt het net zo. PerplexityBot ontdekt en toont websites in de zoekresultaten van Perplexity. Perplexity-User wordt actief zodra iemand een vraag stelt en Perplexity een pagina bezoekt voor een accuraat antwoord.
Kort gezegd wijzen de user-varianten op bezoeken die samenhangen met een vraag op dat moment. De reguliere bots, zoals GPTBot en ClaudeBot, zijn vooral gericht op bredere crawling of het verzamelen van trainingsdata.
Voor GEO zijn beide relevant. De user-agents laten zien wanneer je content bij een concrete vraag wordt geraadpleegd. De bots laten zien of je domein als geheel wordt meegenomen in het bredere beeld dat een AI-model van het web samenstelt.
SEO-data versus AI-crawlerdata
Sterke prestaties in traditionele SEO garanderen allerminst dat een pagina ook terugkomt in AI-crawlerdata. Dat was een van de opvallendste bevindingen. We zagen pagina’s met veel organisch verkeer, hoge posities en veel klikken in Search Console die in de serverlogs nauwelijks door AI-crawlers werden bezocht. En we zagen het omgekeerde. Pagina’s die in Google amper scoren, werden opvallend vaak door AI-crawlers opgehaald.
Die mismatch valt te verklaren. AI-systemen lijken andere signalen te wegen dan Google. Google leunt sterk op zoekwoorden, rankingposities en klikgedrag. AI-crawleractiviteit hangt sterker samen met de bruikbaarheid van een pagina als bron binnen een antwoord. Hoe duidelijk is de context, hoe herkenbaar zijn de entiteiten, en hoe goed past de pagina binnen het bredere thema van de website?
Dat verandert hoe je prioriteiten stelt:
| Situatie | Mogelijke vervolgstap |
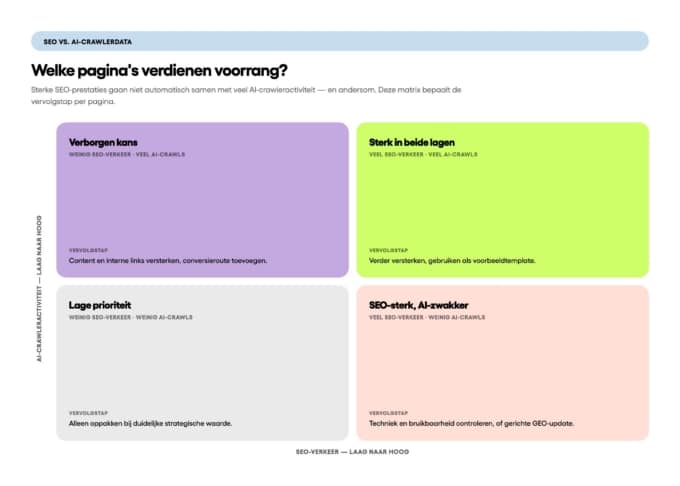
| Veel SEO-verkeer + veel AI-crawleractiviteit | Verder versterken, gebruiken als voorbeeldtemplate |
| Veel SEO-verkeer + weinig AI-crawleractiviteit | Techniek en inhoudelijke bruikbaarheid controleren, of gerichte GEO content update |
| Weinig SEO-verkeer + veel AI-crawleractiviteit | Verborgen kans: content en interne links versterken, conversieroute toevoegen |
| Weinig SEO-verkeer + weinig AI-crawleractiviteit | Alleen oppakken bij duidelijke strategische waarde |
Deze matrix gebruiken we inmiddels structureel bij klanten. Zo bepalen we welke bestaande pagina’s als eerste aandacht verdienen, op basis van het volledige beeld: SEO-cijfers én AI-crawlerdata. Onze AI-logger hebben we doorontwikkeld tot GEO Serverlogs, de module binnen onze Smartstack die deze meetlaag ook voor klanten beschikbaar maakt.
Hoe analyseer je je zichtbaarheid in AI-zoekresultaten?
Je hebt hier geen experiment van twaalf maanden voor nodig. Je hebt je eigen serverlogs nodig. In vijf stappen weet je of AI-crawlers jouw pagina’s ophalen.
- Vraag je logs op. Bel of mail je hostingpartij en vraag om de access logs van de laatste 30 tot 90 dagen. Meestal krijg je ze in het combined log format, met per regel het IP-adres, het tijdstip, de URL, de statuscode en de user-agent. Dat laatste veld heb je nodig.
- Filter op AI-user-agents. Begin met de crawlers uit de tabel hierboven: ChatGPT-User, OAI-SearchBot, GPTBot, ClaudeBot, Claude-User, PerplexityBot en Perplexity-User. Vul later aan met de crawlers van Google, Microsoft en Meta. Nieuwe user-agents komen er regelmatig bij, dus controleer de lijst per kwartaal.
- Controleer of de hits echt zijn. User-agents zijn te vervalsen. Verifieer de belangrijkste hits tegen de gepubliceerde IP-ranges van de aanbieders. Anders tel je scrapers mee als AI-zichtbaarheid.
- Tel per pagina, niet per site. Zet crawls per URL per maand naast elkaar. Zo zie je welke pagina’s bronmateriaal zijn en welke worden overgeslagen. Een sitetotaal vertelt je niets over waar je moet ingrijpen.
- Leg het naast je Search Console-data. Exporteer je pagina’s met vertoningen en klikken, koppel ze op URL aan je crawlcijfers en zet ze in de matrix hierboven. Daar rollen je eerste vier prioriteiten uit.
Kom je er niet uit bij je hostingpartij? Dan is dat op zichzelf al een signaal. Zonder toegang tot je logs kun je ranken in AI niet meten en stuur je op onderbuikgevoel.
De belangrijkste lessen op een rij
Na twaalf maanden testen, meten en bijsturen bij 20 bedrijven kristalliseerden zich zes patronen uit die telkens terugkwamen, ongeacht branche of uitgangssituatie.
Techniek is randvoorwaardelijk, geen groeimotor
Technische optimalisaties bleken belangrijk, maar vooral als basisvoorwaarde. Crawlbaarheid, indexeerbaarheid, JavaScript-toegankelijkheid, robots.txt en sitemaps moeten op orde zijn voordat je content- en GEO-aanpassingen kunt beoordelen.
Geen enkele technische hypothese liet zien dat één losse ingreep automatisch tot meer AI-zichtbaarheid leidt. Ze lieten vooral zien dat technische problemen de rest van je aanpak blokkeren of vertroebelen. Techniek is een noodzakelijke basis onder elke verdere optimalisatie, geen zelfstandige hefboom.
Contentstructuur en semantische duidelijkheid winnen
Goed gestructureerde content lijkt kansrijker dan losse tekstaanpassingen. Dat was een van de duidelijkste signalen. Pagina’s met heldere koppen, concrete antwoorden, definities, voorbeelden en interne vervolgstappen bieden een sterkere basis voor SEO én GEO.
Dat betekent niet dat je content kunstmatig “voor AI” moet schrijven. De betere richting is content die voor mensen duidelijker en bruikbaarder is. Diezelfde duidelijkheid helpt zoekmachines en AI-systemen om de inhoud te verwerken.
Thematische samenhang telt zwaarder dan losse pagina’s
Losse pagina’s bleken minder sterk wanneer ze niet goed verbonden zijn met een breder thema. Contentclusters, pillar pages en gerichte interne linking helpen om context op te bouwen. Voor GEO weegt dat extra zwaar. AI-systemen verwerken losse tekstfragmenten, en leggen daarnaast verband tussen een pagina en het bredere thema van een website. De meeste waarde lijkt daardoor te zitten in thematische structuren.
Reviews, ervaringen en procesuitleg vergroten vertrouwen
Bij meerdere hypotheserichtingen kwam vertrouwen terug als een centraal thema. Reviews, cases, klantvragen, procesuitleg en concrete praktijkvoorbeelden maken content minder generiek, en helpen gebruikers beter te begrijpen waarom een bedrijf relevant of betrouwbaar is. Deze onderdelen zijn vooral kansrijk bij vragen waarin keuzezekerheid, ervaring of dienstverlening centraal staan, denk aan “welke aanbieder is geschikt voor…” of “hoe werkt het proces bij…”.
Losse GEO-tactieken zijn ondersteunend, geen kernstrategie
Onderdelen zoals llms.txt, IndexNow, AI-sharebuttons en promptgestuurde zichtbaarheid kunnen nuttig zijn. Als kernstrategie bleken ze niet sterk genoeg. Ze kunnen ondersteunen of een bruikbare test opleveren. Maar ze worden pas waardevol wanneer de basis klopt: goede content, toegankelijke techniek, duidelijke structuur, autoriteit en meetbaarheid.
Bronwaarde weegt zwaarder dan traditionele SEO-signalen
Dit is de les waar we onze hand voor in het vuur steken. Ranken in AI draait om bronwaarde, niet om je positie in Google. Pagina’s met veel SEO-verkeer zijn in onze data niet automatisch de pagina’s die het vaakst door AI-crawlers worden opgehaald. De vraag verschuift van “welke pagina scoort in Google?” naar “welke pagina is bruikbaar om een antwoord mee te vormen?”

